リアルタイム 2D から 3D へ:深度マップからステレオビューまで
普通の画像に Vision Pro で奥行きを与えるには?単眼深度推定、ステレオビュー合成、そしてこの処理を動画へ拡張するためのエンジニアリングを探ります。
普通の写真を Vision Pro で立体的に見せることはできるでしょうか。入力が動画プレーヤーの一フレームなら、同じ方法を再生中に使えるでしょうか。
この疑問から StereoImaging の実験を始めました。基本的な流れはシンプルです。画像の相対的な深度を推定し、その情報からわずかに異なる二つのビューを合成して、左右の目に一つずつ表示します。
この記事では、2025 年 4 月の実験ノートを改めて整理します。まず静止画から始め、入力が連続する動画フレームになったときに何が変わるのかを考えます。ここでいう「リアルタイム」は目指す用途を表しており、元のノートには再現可能なフレームレートや遅延のベンチマークは含まれていません。
二つのビューが奥行きを生む理由
私たちの左右の目は、わずかに異なる位置から同じ場面を見ています。そこから生じる画像の差、つまり両眼視差は、視覚系が奥行きを判断する手がかりの一つです。
視点を動かすと直感的に理解できます。一般に、画像上では近くの物体ほど遠くの物体より大きく移動します。理想的な平行ステレオカメラモデルでは、視差は焦点距離とカメラ間の距離が大きいほど増え、被写体までの距離が大きいほど減ります。
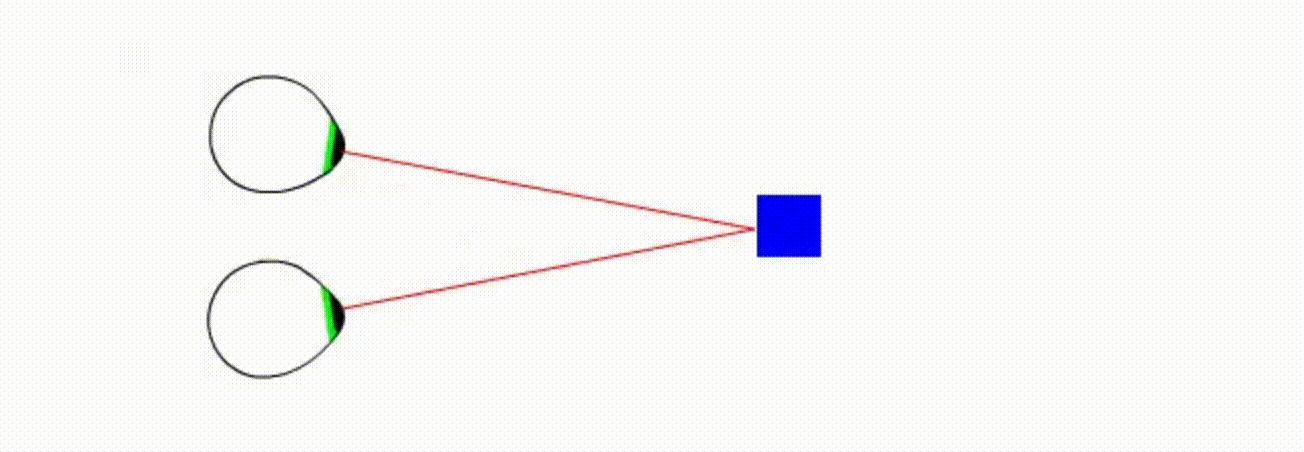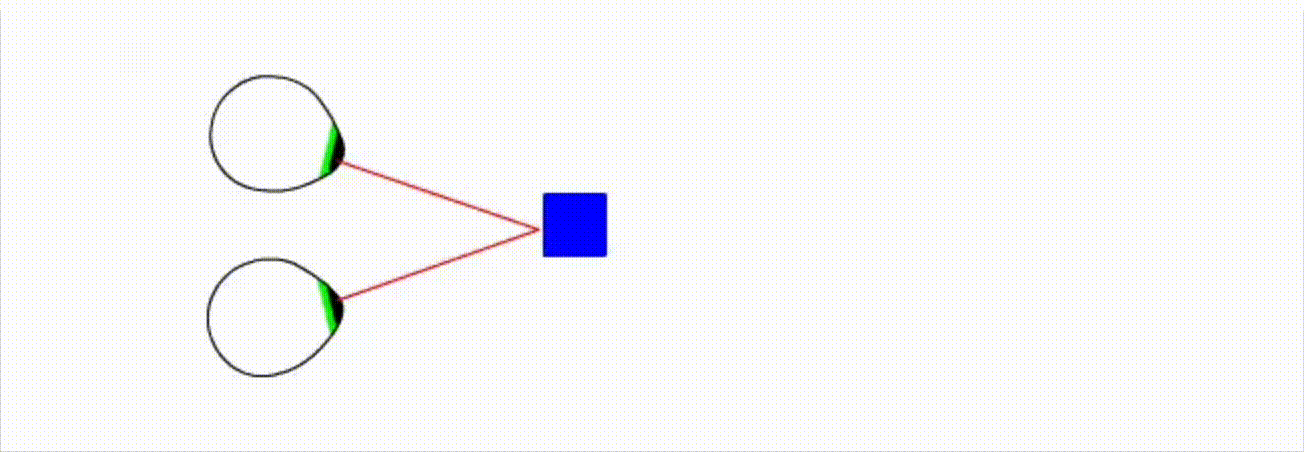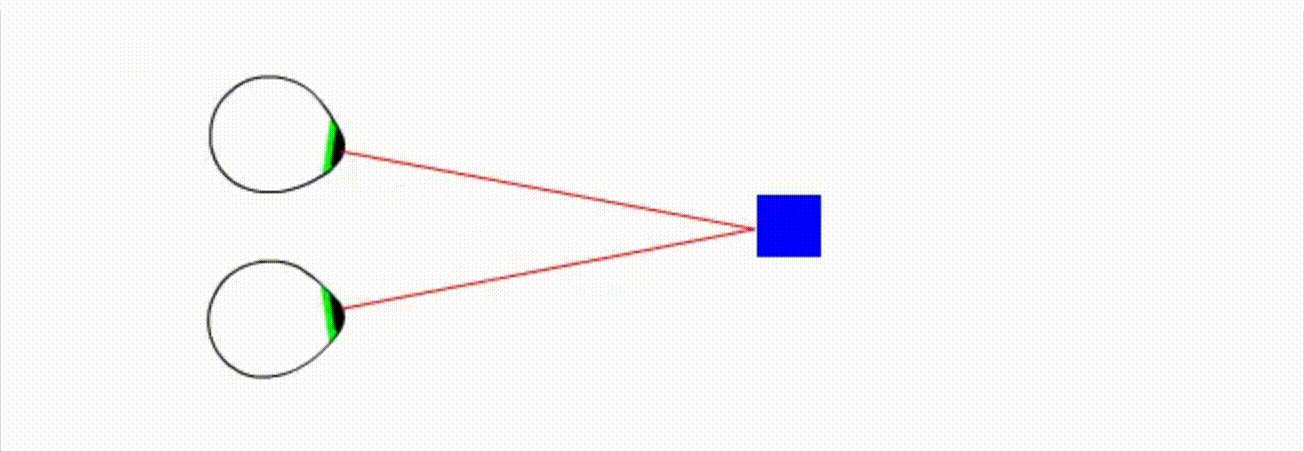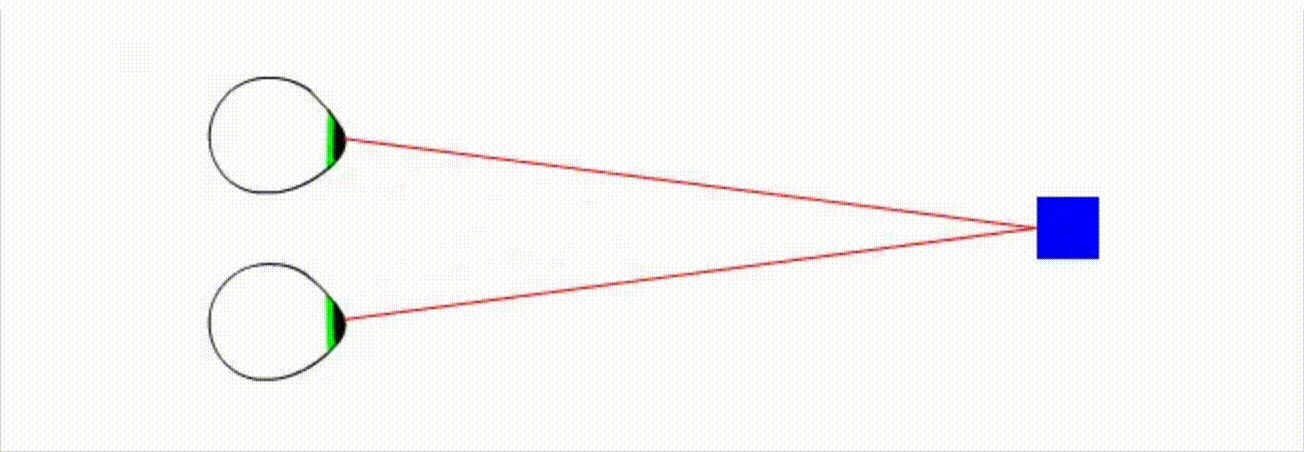
既存の 2D 画像には、二台目のカメラから見た画像がありません。そこで深度を推定し、その結果を使って視点の変化を合成します。これにより立体的な奥行きの手がかりは作れますが、任意の位置から見られる完全な 3D シーンを復元できるわけではありません。
画像と深度マップから始める
実験に使用した元画像です。
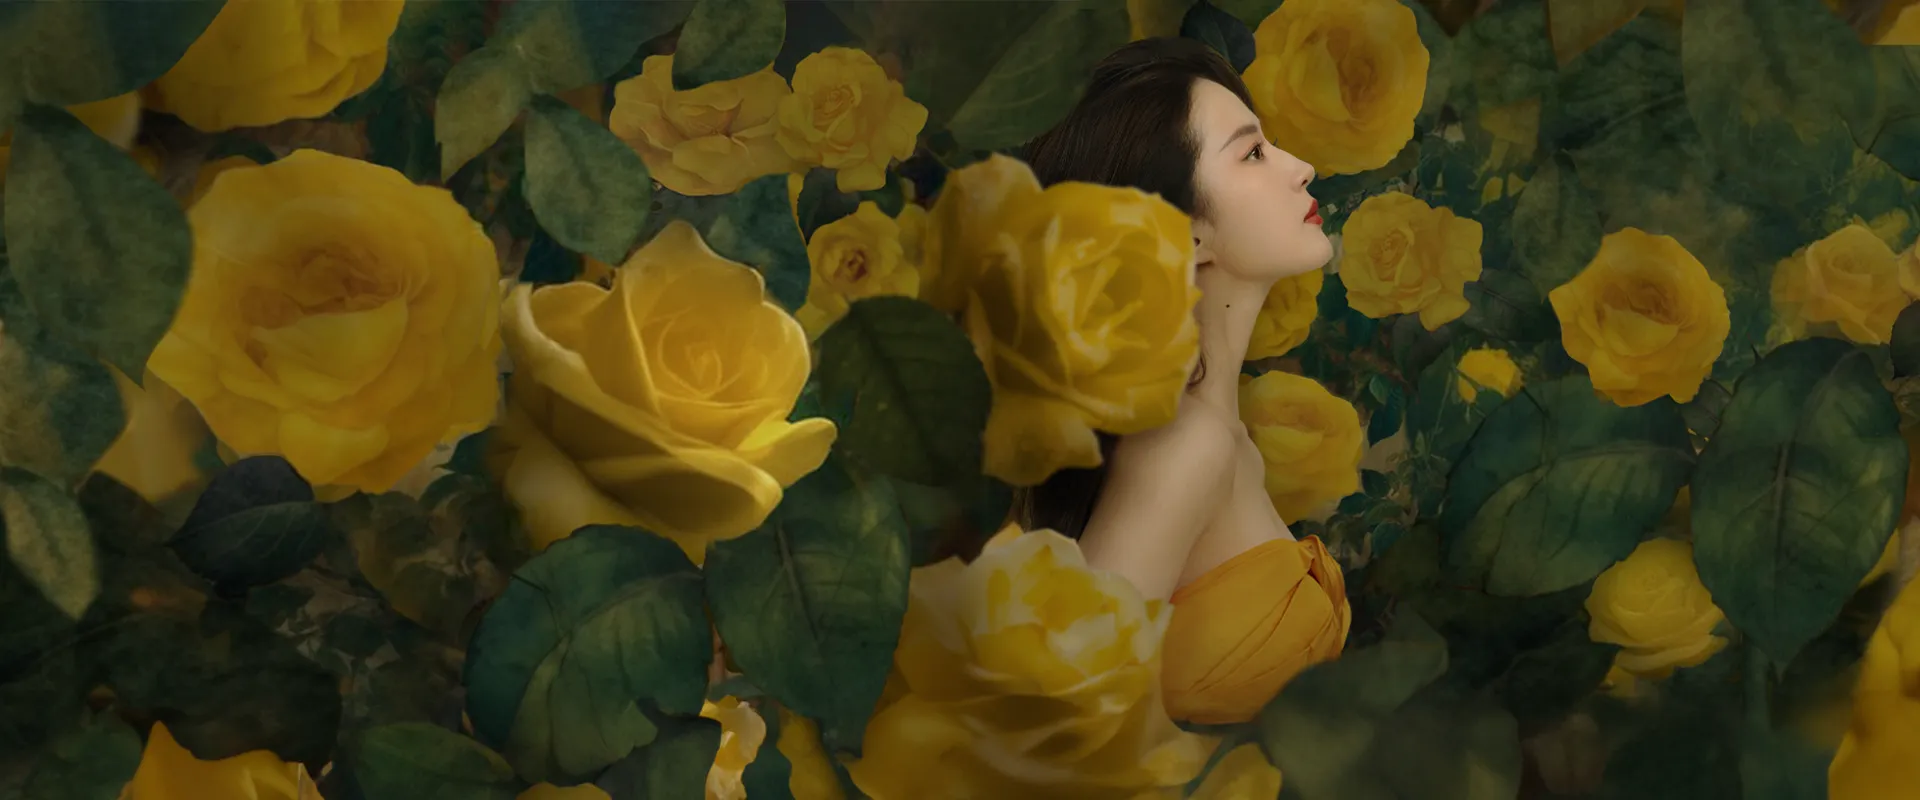
次の段階は単眼深度推定です。Depth Anything V2 は選択肢の一つです。標準モデルは相対深度を推定し、別途ファインチューニングされたモデルはメートル単位の深度を扱います。Apple プラットフォームでは、Apple の Core ML モデルカタログにアプリへ組み込めるモデルが用意されています。
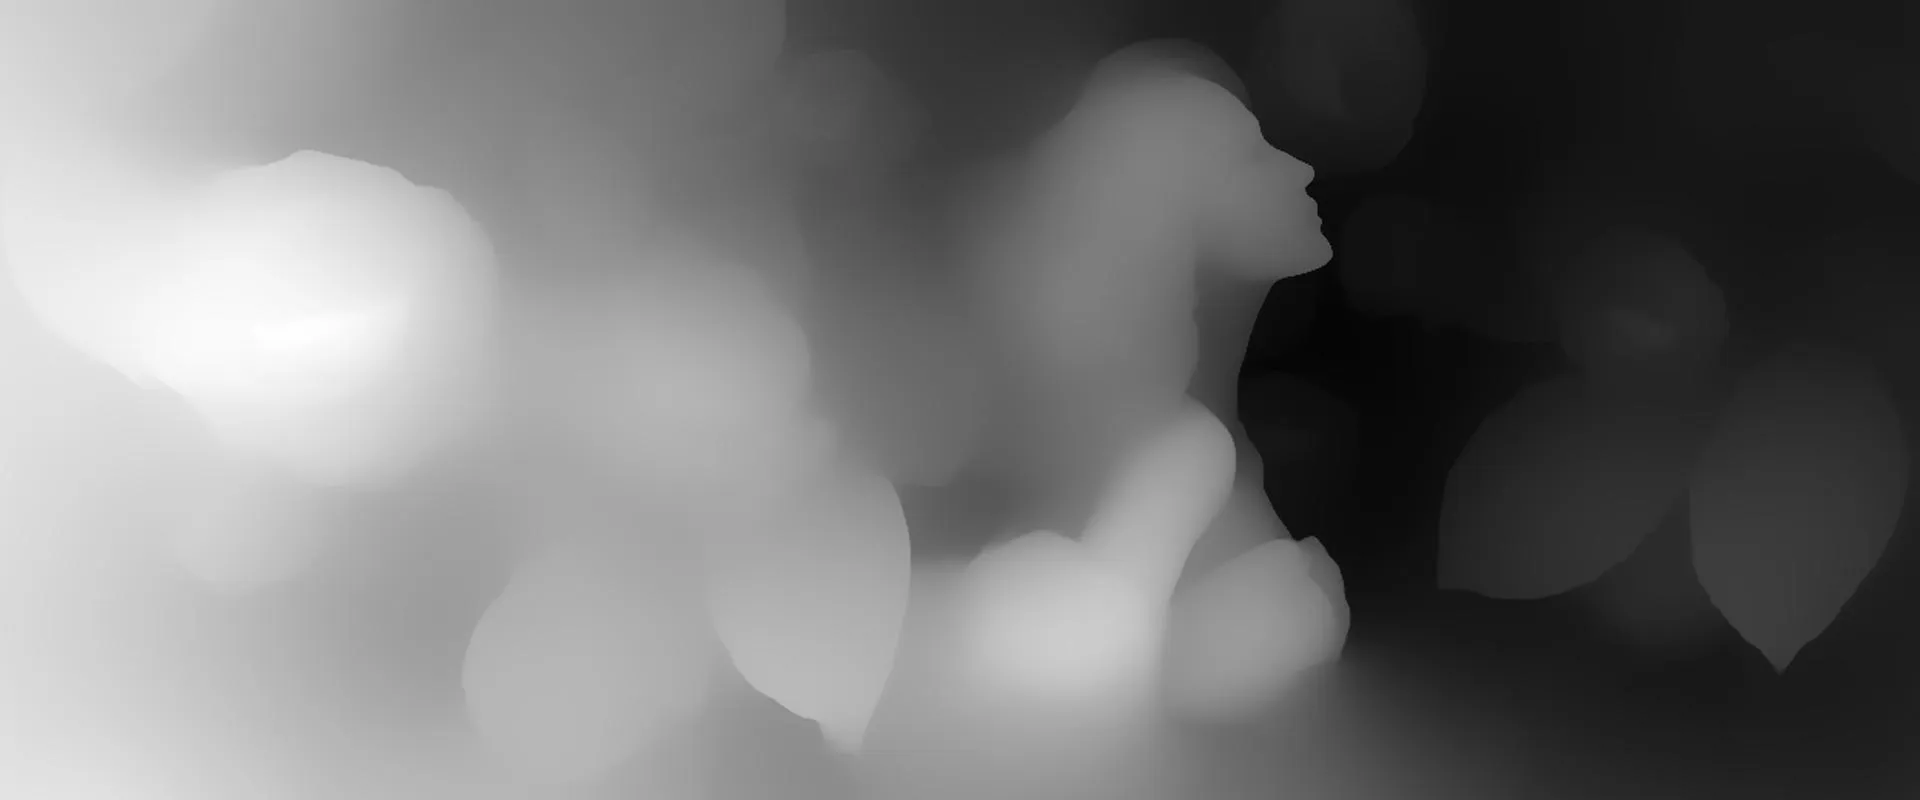
この可視化では、近い領域を白、遠い領域を黒で表しています。この規則を物理的な距離と区別するため、正規化された_近さ_を d とします。
1に近いほど、見る人に近いことを示します。0に近いほど、背景の奥にあることを示します。0–255は表示用のグレースケール表現です。255で割ると正規化された値になりますが、メートル単位の距離ではありません。
出力の解釈は重要です。モデルをレンダラーへつなぐ前に、出力が何を表すのか、どちらの方向が「近い」のか、どのように正規化されているのかを確認する必要があります。変数名が depth であるだけでは、こうした詳細は分かりません。
深度をステレオ視差へ変換する
奥行きの順序が分かれば、前景を大きく、背景を小さくずらせます。
概念を示す簡単な対応式は次のとおりです。画像座標は右向きに増加し、d0 は表示面に置きたい基準深度、k は視差の強さを制御します。
disparity = k × (d - d0)
x_left    = x + disparity / 2
x_right   = x - disparity / 2
d = d0 では、左右のビューに水平方向のずれはありません。より近い領域と遠い領域は、基準面の反対側へ分かれます。ここで k の単位はピクセルなので、出力解像度と合わせて値を決める必要があります。
これは考え方を説明するための再投影式であり、キャリブレーション済みの完全なレンダリングアルゴリズムではありません。実装では、ピクセルのサンプリング方法、複数のピクセルが同じ位置へ写るときにどの面を優先するか、どの元ピクセルも出力先を覆わない場合にどうするかも決める必要があります。
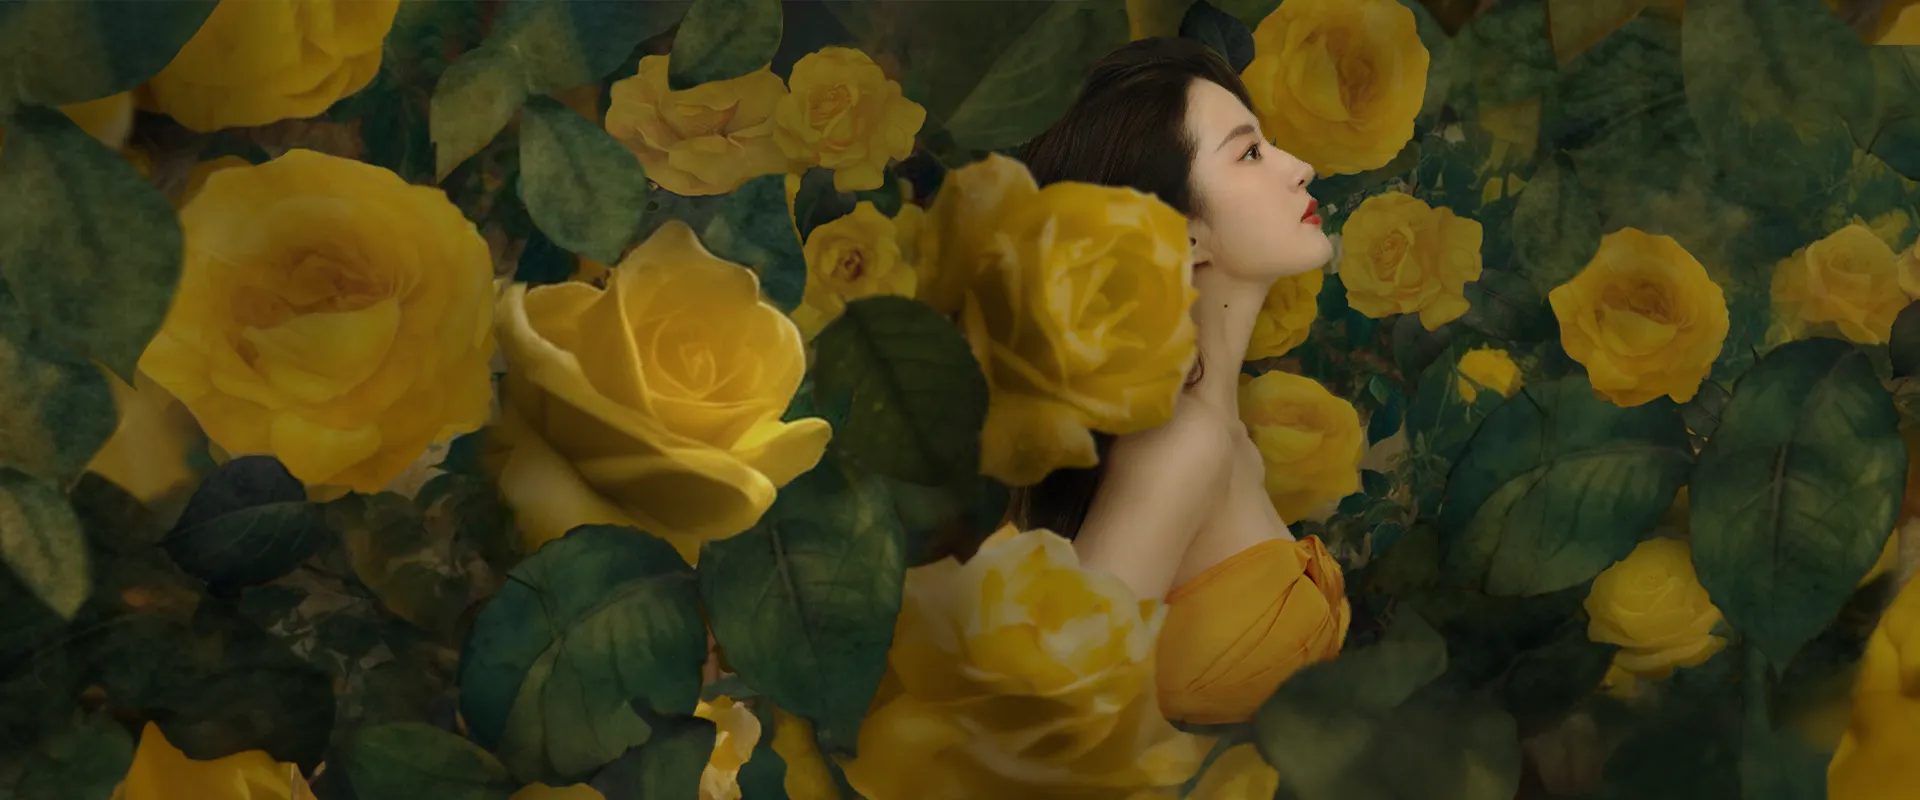
実験では次の一組を生成しました。まず左目用のビューです。
続いて右目用のビューです。
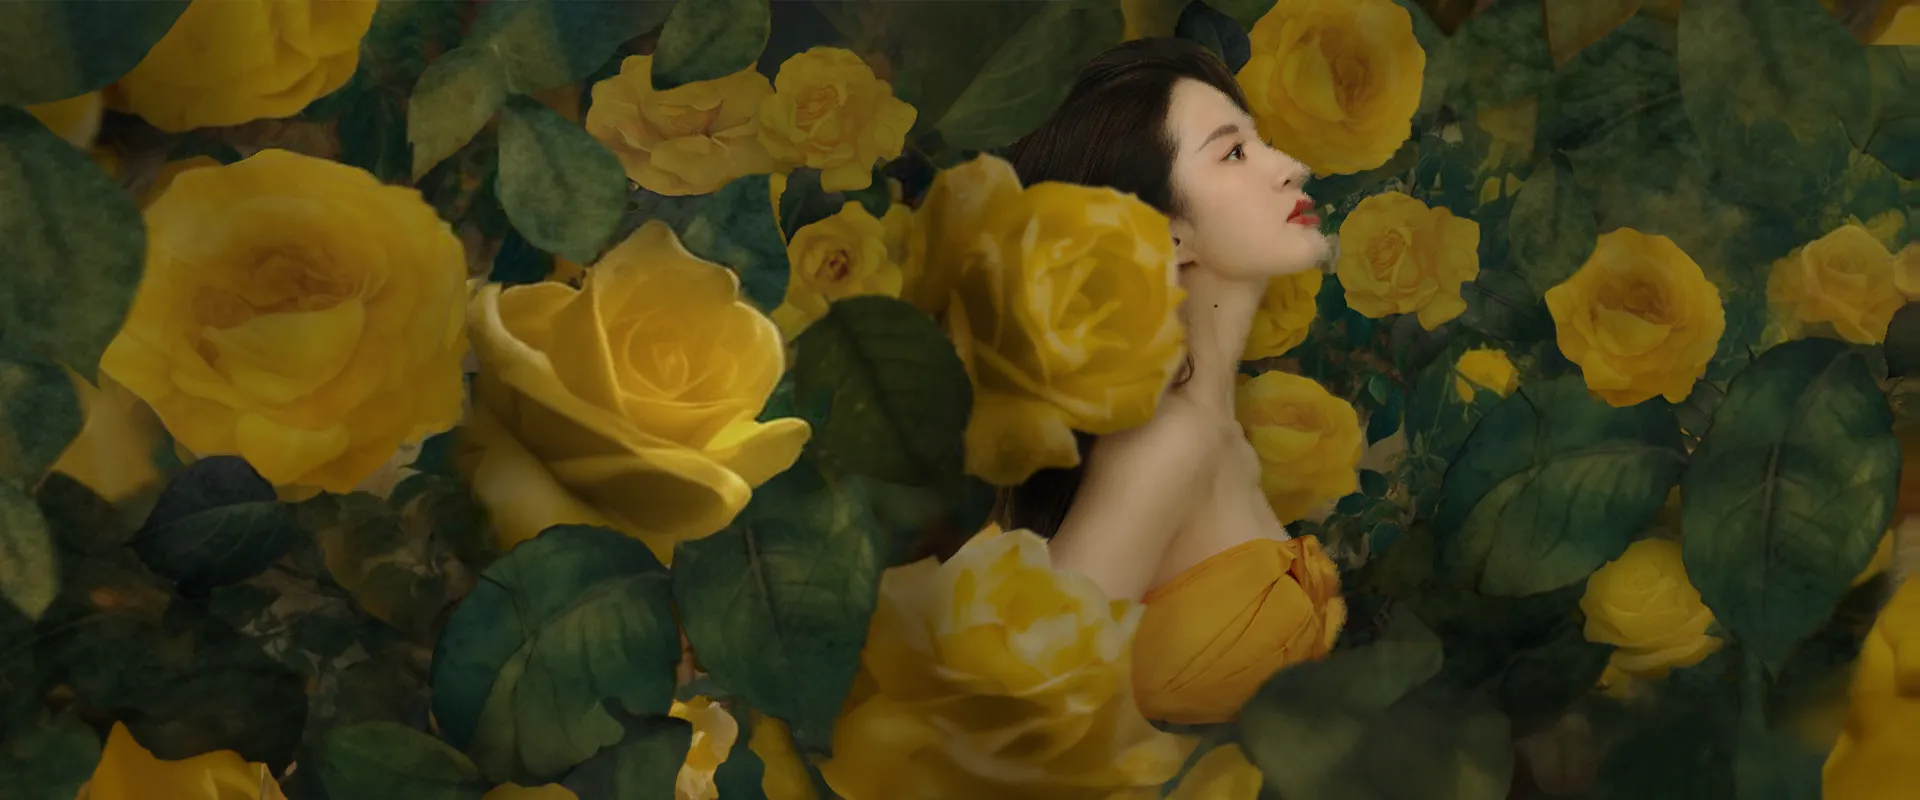
二つの画像はよく似ていますが、局所的な位置が異なります。深度が、その差の分布を決めます。それぞれの目に対応するビューを見せると、立体効果が生まれます。
視差は大きければよいわけではありません。ずれを大きくすると奥行き感は強まりますが、背景の欠損、引き伸ばされた輪郭、視覚的な不快感も目立ちます。小さな視差から始め、対象となるディスプレイで結果を評価するのがよいでしょう。
左右の目に正しい画像を表示する
二つの画像は、ステレオ表示に対応したレンダリング経路で提示する必要があります。通常のウインドウに横並びで置くだけでは自動的に立体映像にはなりません。左右を入れ替えると、意図した視差も反転します。
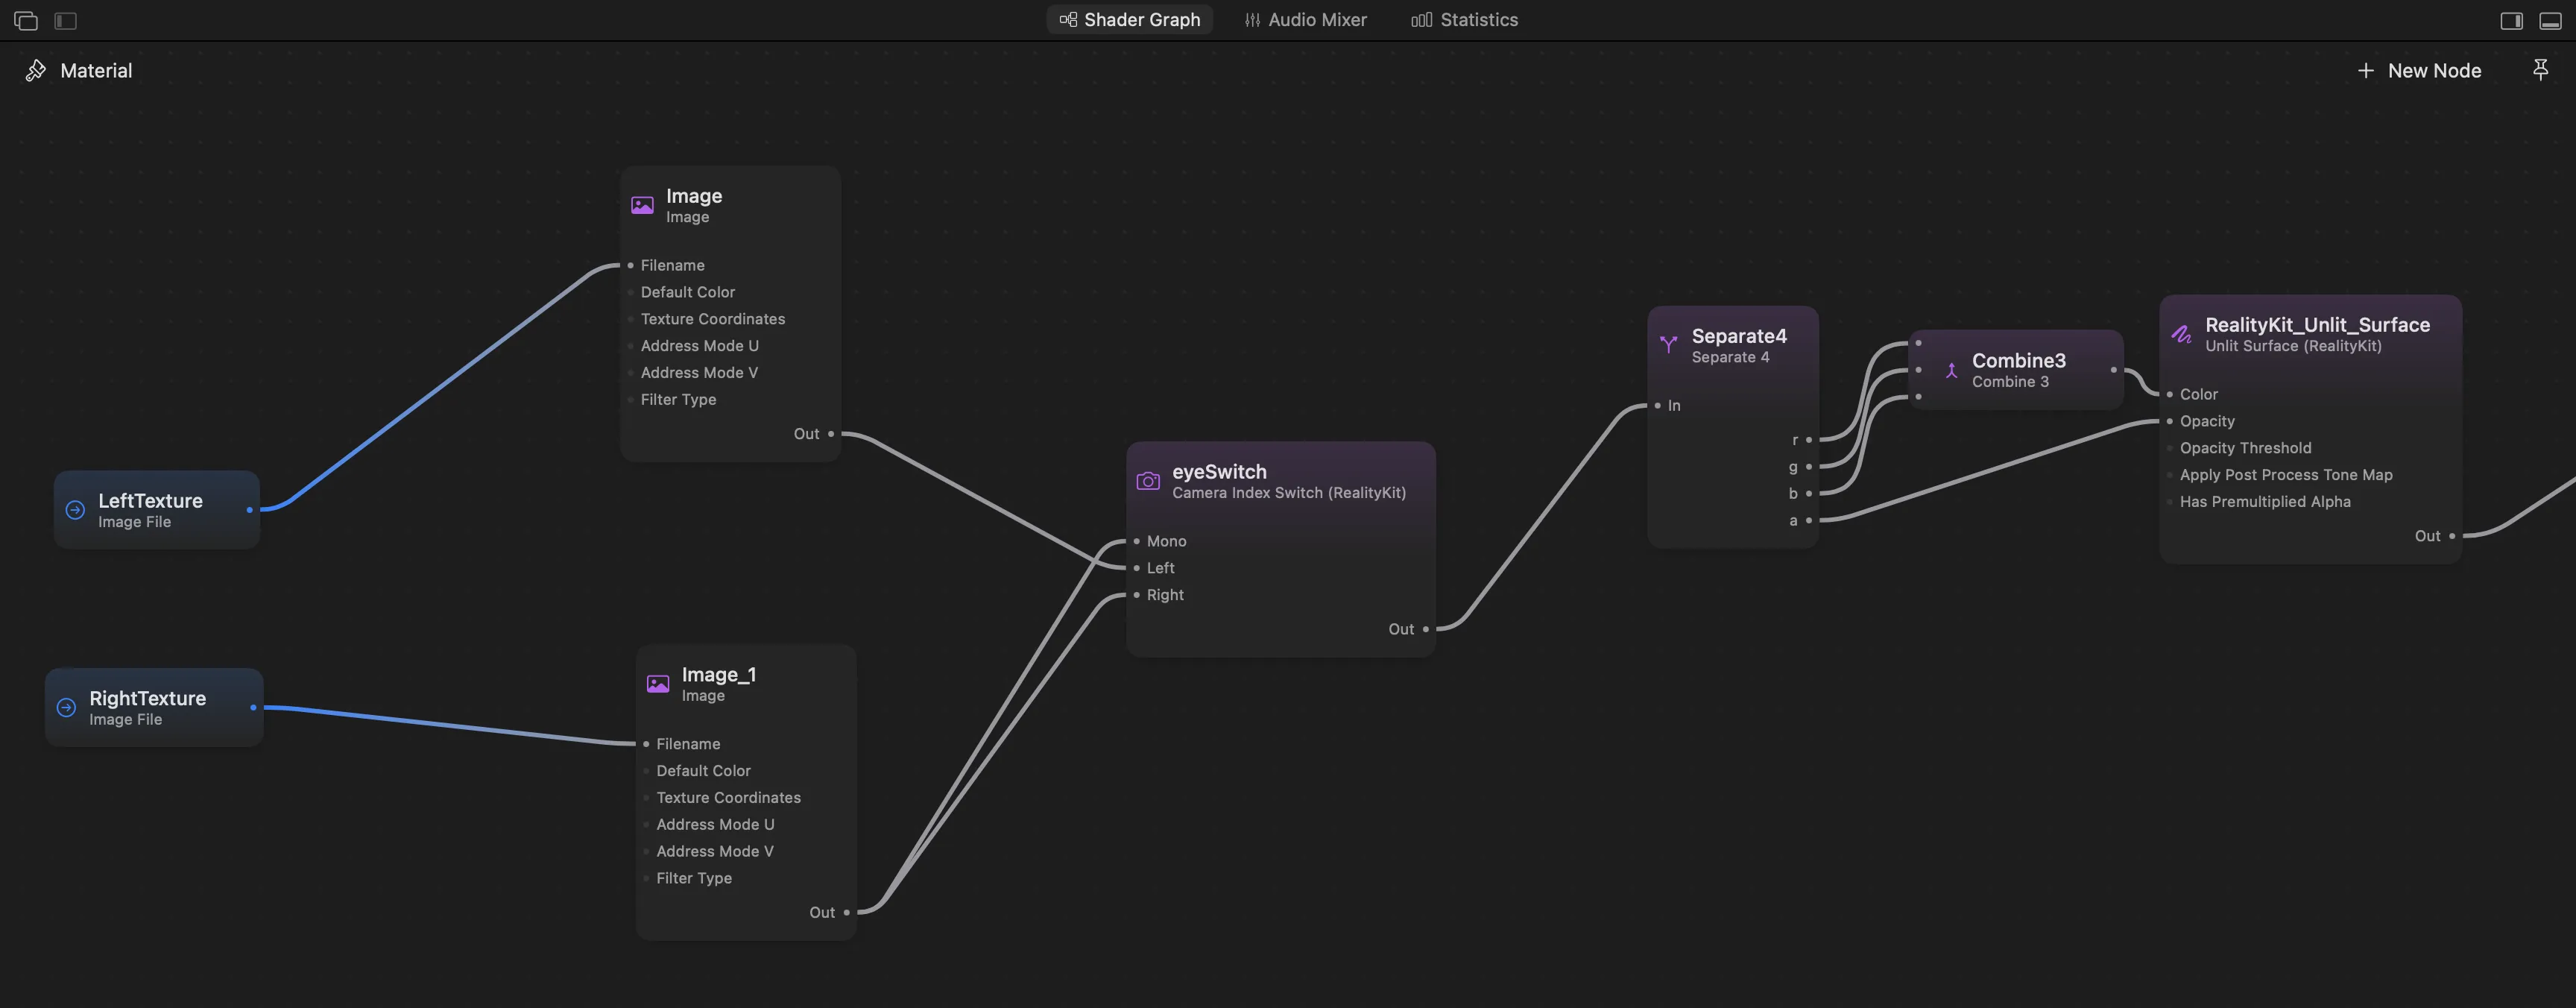
visionOS では、シェーダーグラフの Camera Index Switch ノードを使い、目ごとに異なるテクスチャを選択できます。Left と Right の入力はステレオレンダリングに使われ、Mono は単一ビューの結果を提供します。Apple のステレオ画像のサンプルで、この構成を確認できます。
実験ノートのグラフでは、LeftTexture と RightTexture が目を選択するノードへ入り、その出力がライティングなしのサーフェスに色と不透明度を与えます。
2D 画面で読む人にも違いが分かるように、元の実験では左右の画像を交互に表示する GIF を用意しました。次のアニメーションはそのデモを残したものです。
このアニメーションは視点が左右に揺れているように見えますが、ヘッドトラッキングは含まれていません。また、見る人が動いたときにシーンの新しい部分が現れることを示すものでもありません。
静止画からリアルタイム動画へ
画像処理の流れは、動画プレーヤーから得られる各フレームにも適用できます。
動画フレームをデコード
        ↓
深度を推定
        ↓
左右のビューを合成
        ↓
再生に同期してステレオフレームを表示
概念上は静止画の処理を繰り返すだけです。しかし実際には、処理期限と時間方向の一貫性という問題が加わります。変換が再生に追いつけるかどうかは、モデル内部の処理時間だけでなく、デコード、推論、再投影、データ転送、表示を含む経路全体で決まります。
この実験を再生パイプラインへ発展させるなら、次の四点を重視します。
- キューを制限する。 処理が遅れたときにフレームをため続けると、遅延が増えます。同時に処理する量を制限し、再生クロックを使って、まだ処理する価値のあるフレームを判断します。
- データ移動を計測する。 デコード済みフレーム、モデル入力、深度出力、レンダリング用テクスチャの間の変換には、大きなオーバーヘッドが生じることがあります。経路全体を計測します。
- 深度解像度と輪郭品質のバランスを取る。 推論入力を小さくすれば計算量は減らせますが、出力した深度マップの拡大によって、シルエットや細部の位置合わせが弱くなる場合があります。
- 時間方向の深度を安定させる。 各フレームの深度マップがもっともらしくても、再生中の深度が安定するとは限りません。Depth Anything V2 は画像向けの手法なので、時間フィルタリングや動画専用モデルは別に検討する必要があります。プロジェクト資料
これらは実験を拡張する際のエンジニアリング上の方向性であり、結果によって効果が確立した最適化ではありません。有用な性能レポートには、デバイス、入力解像度、モデル構成、エンドツーエンド遅延、継続再生時の挙動を記録する必要があります。
錯覚が崩れる場所
元画像には、被写体に隠された背景が存在しません。 前景の物体をずらすと、既知のピクセルがない領域が現れることがあります。単純な再投影では穴が残り、簡単な補間ではにじみや引き伸ばしが生じます。こうした領域には、明示的な復元または補完方法が必要です。
推定深度は誤ることがあります。 髪、透明な物体、反射、複雑な輪郭は特に注意して確認すべきです。深度マップの小さな誤差が、再投影後には左右の目で目立つ不一致になることがあります。
動画には安定した深度スケールが必要です。 フレームごとに独立して正規化すると、構図の変化に合わせて物体の視差まで変わる場合があります。平滑化はちらつきを抑えられる一方、遅れを加えたり、動きの中にアーティファクトを残したりします。シーン切り替えにも個別の処理が必要です。
したがって、結果を決めるのは深度マップの見た目だけではありません。再投影、遮蔽処理、時間方向の安定性、対象ディスプレイのすべてが体験に影響します。
この方法を活用できる場所
一つの用途は空間インターフェースの画像です。既存のカバー、ポスター、プロモーション画像に対して、別のステレオペアを手作業で用意せず、控えめな奥行き感を加えられます。もう一つは、通常の動画から再生中にステレオビューを合成するプレーヤーです。
元画像、深度マップ、合成した二つのビュー、最終表示を別々の段階として保つと、それぞれの結果を調べやすくなります。次に改善すべき場所が深度推定、画質、処理遅延のどこにあるのかも見極めやすくなります。
コメント
GitHub アカウントでディスカッションに参加できます。コメントはこのブログの Discussions で公開されます。 GitHub で開く